一、什么是数据处理
数据处理(Data Processing)是指对原始数据进行采集、清洗、转换、分析、存储与呈现的一系列操作过程,其目标是将杂乱无章的原始数据转化为可用于决策和行动的信息与知识。在数字化时代,数据处理已成为企业运营、科学研究和社会治理的基础能力。
二、数据处理的典型流程
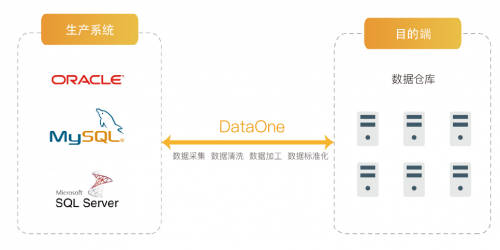
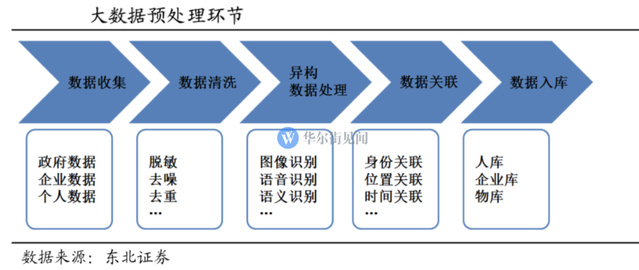
一个完整的数据处理流程通常包括以下几个环节:
- 数据采集:从数据库、传感器、日志文件、API接口、问卷调查等来源获取原始数据。
- 数据清洗:处理缺失值、重复值、异常值和格式不一致的问题,提升数据质量。
- 数据转换:进行标准化、归一化、编码转换、聚合汇总等操作,使数据适合分析。
- 数据分析:运用统计分析、机器学习等方法挖掘数据中的规律与关联。
- 数据存储与呈现:将结果存入数据仓库或以报表、可视化仪表盘等形式呈现给用户。
三、关键方法与工具
在工程实践中,数据处理既有传统批处理方式,也有实时流处理方式。批处理适合大规模离线计算,常用工具包括 Spark、Hadoop;流处理适合实时性要求高的场景,常用工具包括 Flink、Kafka Streams。Python 的 pandas、NumPy 以及 SQL 则是日常数据清洗与分析的核心工具。
四、数据质量是核心
“垃圾进,垃圾出”是数据处理领域的经典准则。无论算法多么先进,低质量的数据都会导致错误的结论。因此,去重、补全、校验和一致性检查应贯穿于数据的整个生命周期,并建立定期监控机制。
五、常见挑战与实践建议
- 数据孤岛:不同系统的数据标准不统一,需建立统一的数据字典和治理规范。
- 隐私与安全:涉及个人信息的数据须脱敏处理,并遵守相关法律法规。
- 成本与效率平衡:合理选择批处理或流处理架构,避免过度设计。
- 可复现性:保留处理脚本与版本记录,确保数据处理过程可追溯、可复现。
六、
数据处理不是一次性任务,而是持续迭代的工程与治理过程。做好数据处理,意味着为后续的分析建模和业务决策打下坚实基础。只有把数据“洗干净、理清楚、用起来”,数据才能真正成为组织的核心资产。